生物医学图像分析
IHC 生物标志物自动分析
在 A*STAR 实习时做的研究,从病理切片中分割细胞核、提取特征并分类。
研究实习生 · A*STAR BII2024 — 202597.9% · 独立切片 B 的四分类准确率
Python计算机视觉随机森林图像处理
这项研究做什么
在 A*STAR 生物信息学研究所实习时,我做的是 IHC 病理切片分析。流程会从整张切片里提取组织区域,分离染色、分割细胞核,再提取特征并分类。最后得到每个细胞核的位置、表达类别,以及整张切片的统计。
我主要分析细胞核周围的染色分布:向外扩展 12 层,每层沿 72 个方向采样,得到 864 维光密度特征。之后比较随机森林、SVM 和 ResNet-18,并用没有参与训练的另一张切片评估。
下面是我 2025 年 5 月 NTU 实践项目报告里的图像和结果。每组数据旁边写了对应的样本范围和报告页码。
- 独立切片 B · 分类准确率
- 97.9%
随机森林 · 2,000 个标注细胞核
- 整片预测规模
- 2.46M
两张切片共 2,455,325 个细胞核
01 / 方法
从整张切片到每个细胞核
实验使用两张 H-DAB 染色的胰腺导管腺癌切片,共三个组织区域。我把原本分散在不同工具里的步骤接成一次运行的流程。
- 01
找到组织
用低分辨率图定位组织区域,排除背景,再读取高分辨率区域。
- 02
分离染色
估计染色矩阵,将苏木精与 DAB 信号分开。
- 03
分割细胞核
2048 × 2048 图块、256 像素重叠,分水岭分割后拼回整张图。
- 04
提取空间特征
从细胞核向外扩展 12 层,每层沿 72 个方向采样 DAB 光密度。
- 05
比较分类模型
用人工核对后的样本比较 RF、SVM 和 ResNet-18,最终接入 RF。
- 06
输出统计结果
保存每个细胞核的特征、预测类别,以及整张切片的类别占比。
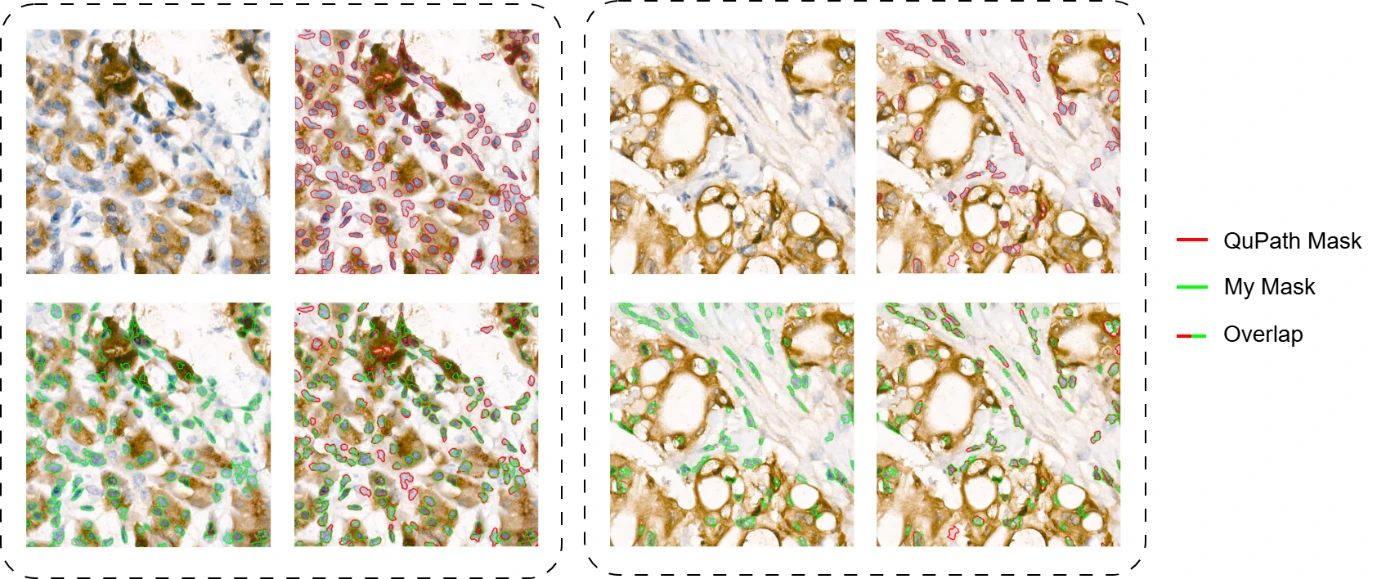
报告第 10–30 页。上方封面为原报告图 6(第 21 页):原图、QuPath 分割、本流程分割及叠加对比。与 QuPath 的掩膜重叠度为 Dice 0.7311、IoU 0.5761;参考对象是软件输出。
02 / 真实样本
每个小图左边是原始细胞图像,右边是它周围的 DAB 光密度分布。外围区域由细胞核向外膨胀近似得到,并非直接测出的细胞膜边界。点击可放大原图。
低表达与膜表达低表达样本的 DAB 信号较弱;膜表达样本的信号更集中在外围。
原报告第 25 页胞质表达与局部表达胞质表达的信号分布较广;Half 类的强信号集中在部分方向。
原报告第 26 页 03 / 结果
换一张切片,模型表现如何?
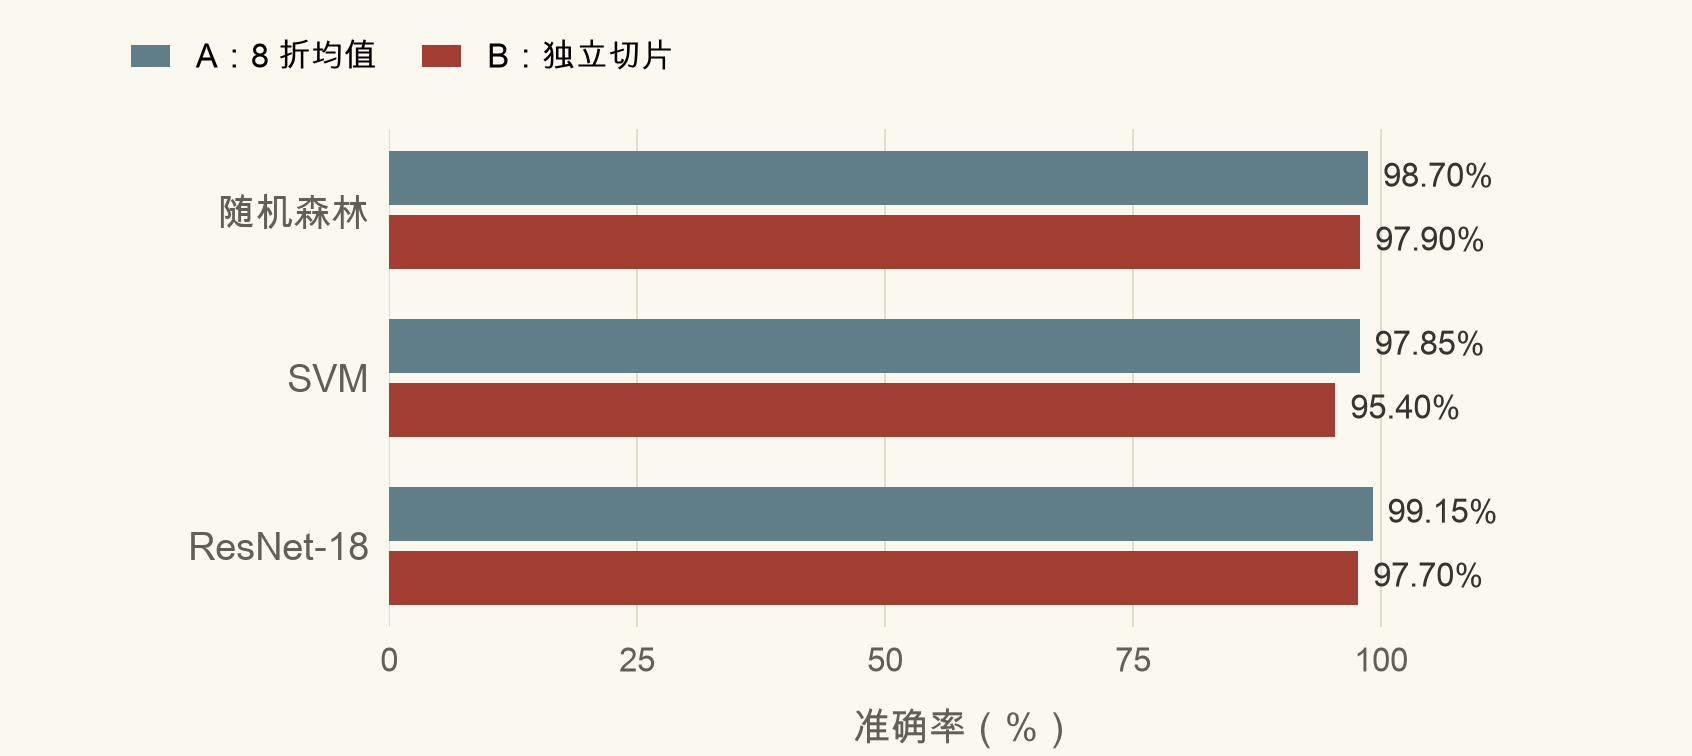
ResNet-18 的交叉验证均值最高;随机森林在切片 B 的 2,000 个独立标注样本上达到 97.90%,略高于 ResNet-18 的 97.70%。结合可解释性和部署成本,我最终使用了随机森林。
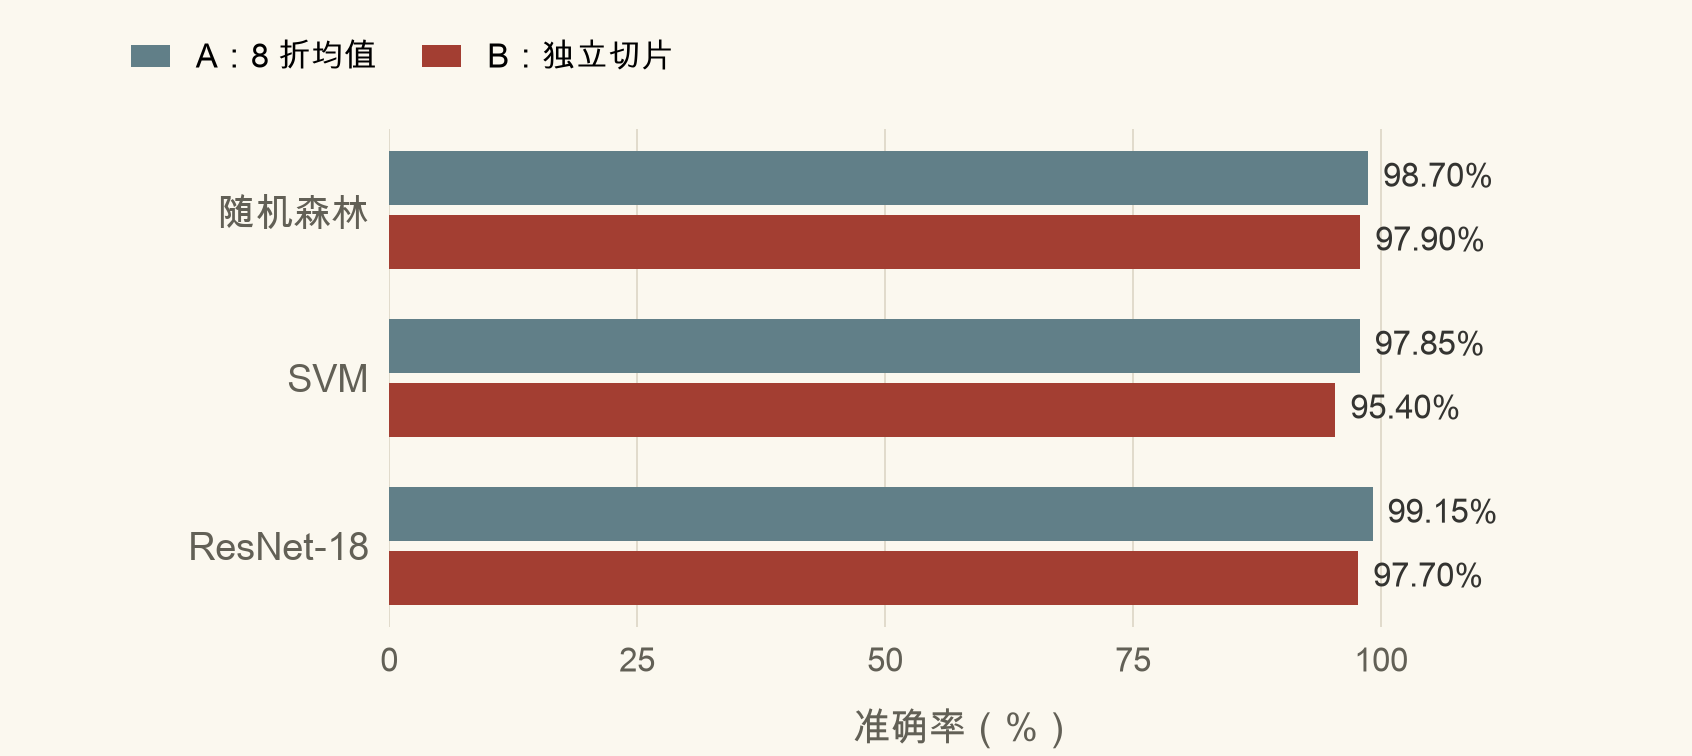 根据原报告数据重绘 · 表 4 · 第 30 页下载图表
查看图表数值
准确率(%);交叉验证的 ± 数值按表 4 保留。| 模型 | 切片 A · 8 折交叉验证 | 独立切片 B |
|---|
| Random Forest | 98.70 ± 0.71 | 97.90% |
|---|
| SVM | 97.85 ± 0.94 | 95.40% |
|---|
| ResNet-18 | 99.15 ± 0.47 | 97.70% |
|---|
切片 A 的 2,000 个样本用于开发与交叉验证;切片 B 的另 2,000 个样本仅用于泛化评估。样本经模型辅助筛选和本人核对,详见报告第 27–30 页。
04 / 结果
两张切片,四种表达模式
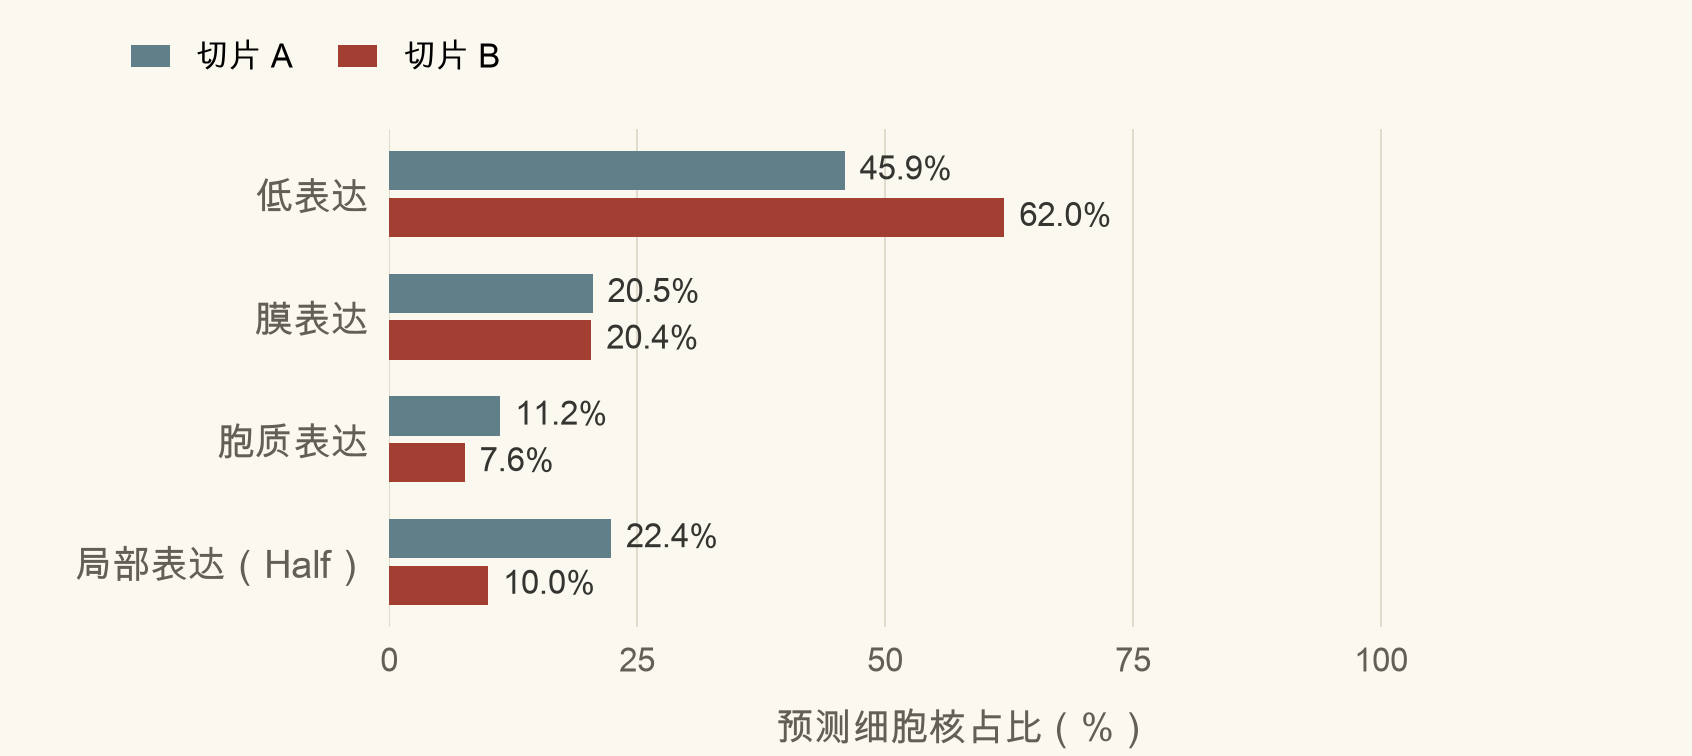
模型共处理了 2,455,325 个分割出的细胞核。切片 B 的低表达占比更高。这里展示的是模型对整张切片的预测分布,不是 245 万个人工标注样本,也不是分类准确率。
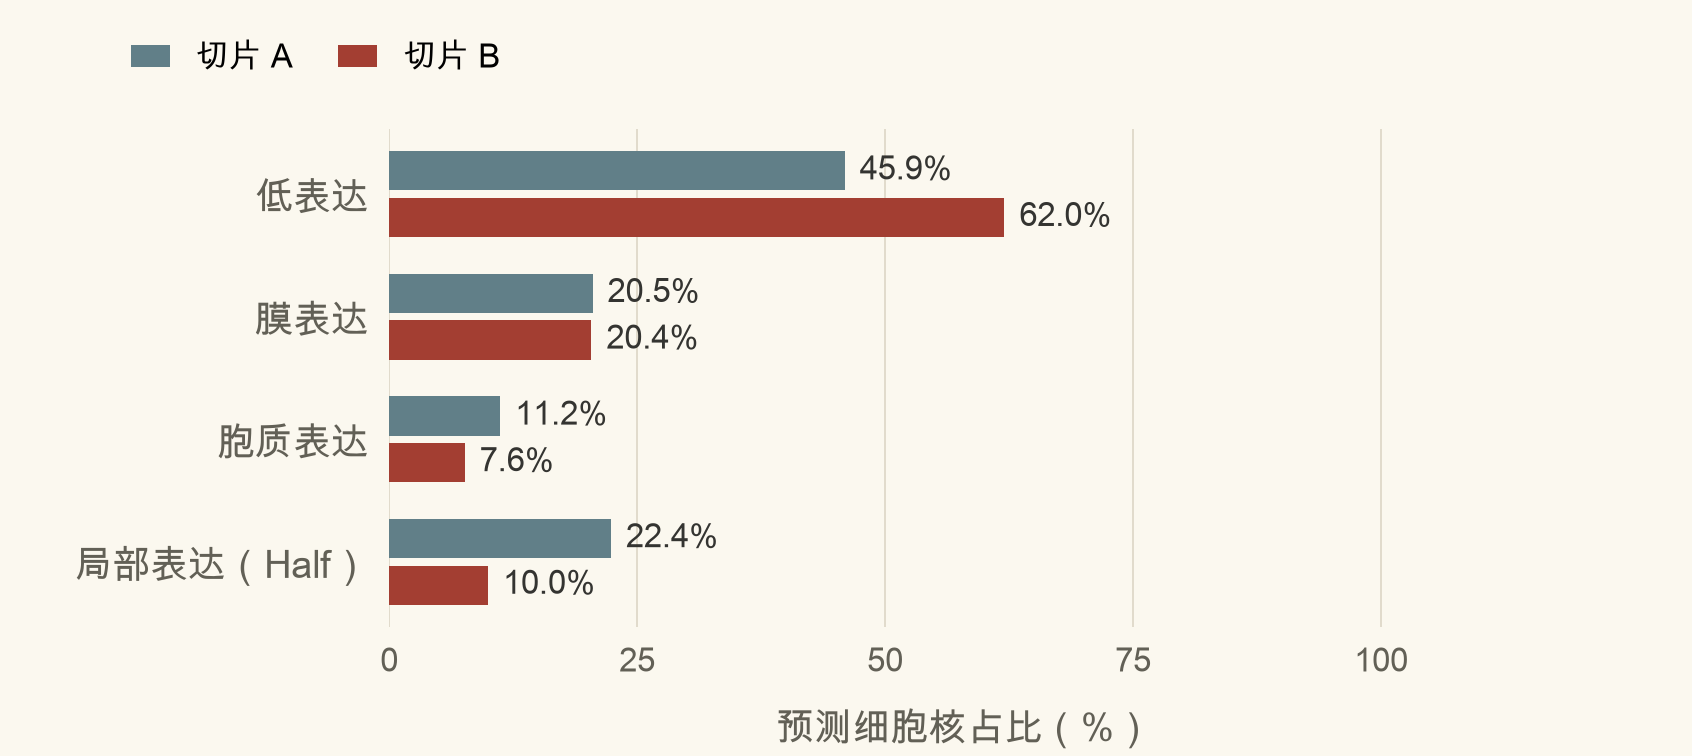 根据原报告数据重绘 · 表 6、7 · 第 37 页下载图表
查看图表数值
每格为预测数量与占比,占比由原始数量计算。| 表达模式 | 切片 A | 切片 B |
|---|
| 低表达 | 422,654 · 45.9% | 952,251 · 62.0% |
|---|
| 膜表达 | 188,659 · 20.5% | 313,020 · 20.4% |
|---|
| 胞质表达 | 103,009 · 11.2% | 116,984 · 7.6% |
|---|
| 局部表达(Half) | 205,762 · 22.4% | 152,986 · 10.0% |
|---|
| 合计 | 920,084 | 1,535,241 |
|---|
05 / 结果
时间主要花在哪里?
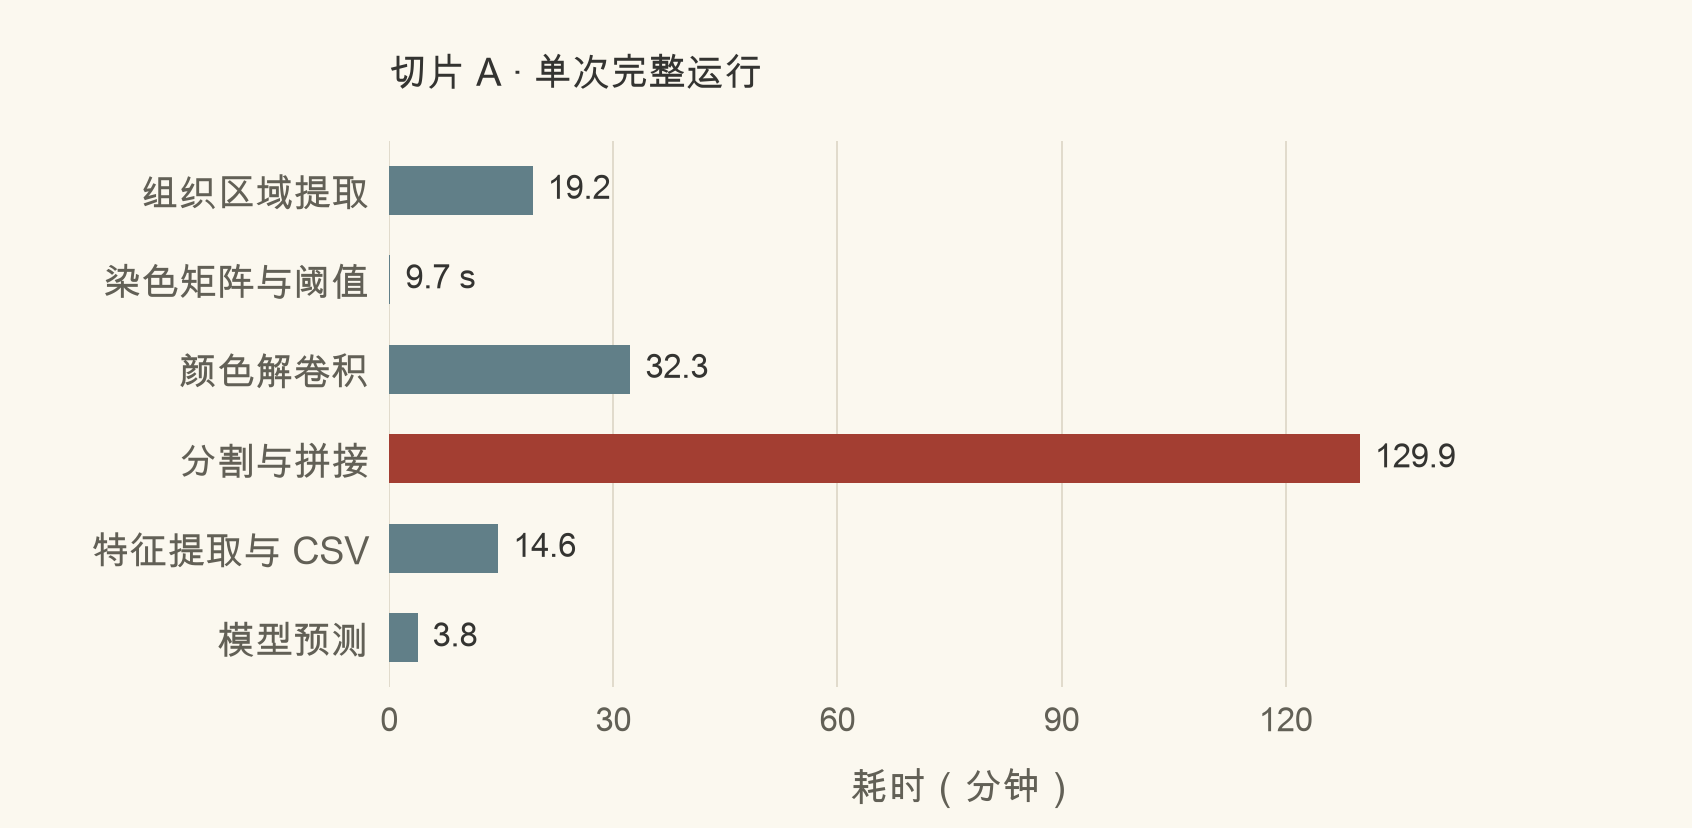
按耗时表相加,切片 A 的完整运行是 11,996 秒,约 3 小时 20 分钟。分割与拼接约占 65%,比分类预测本身更耗时。
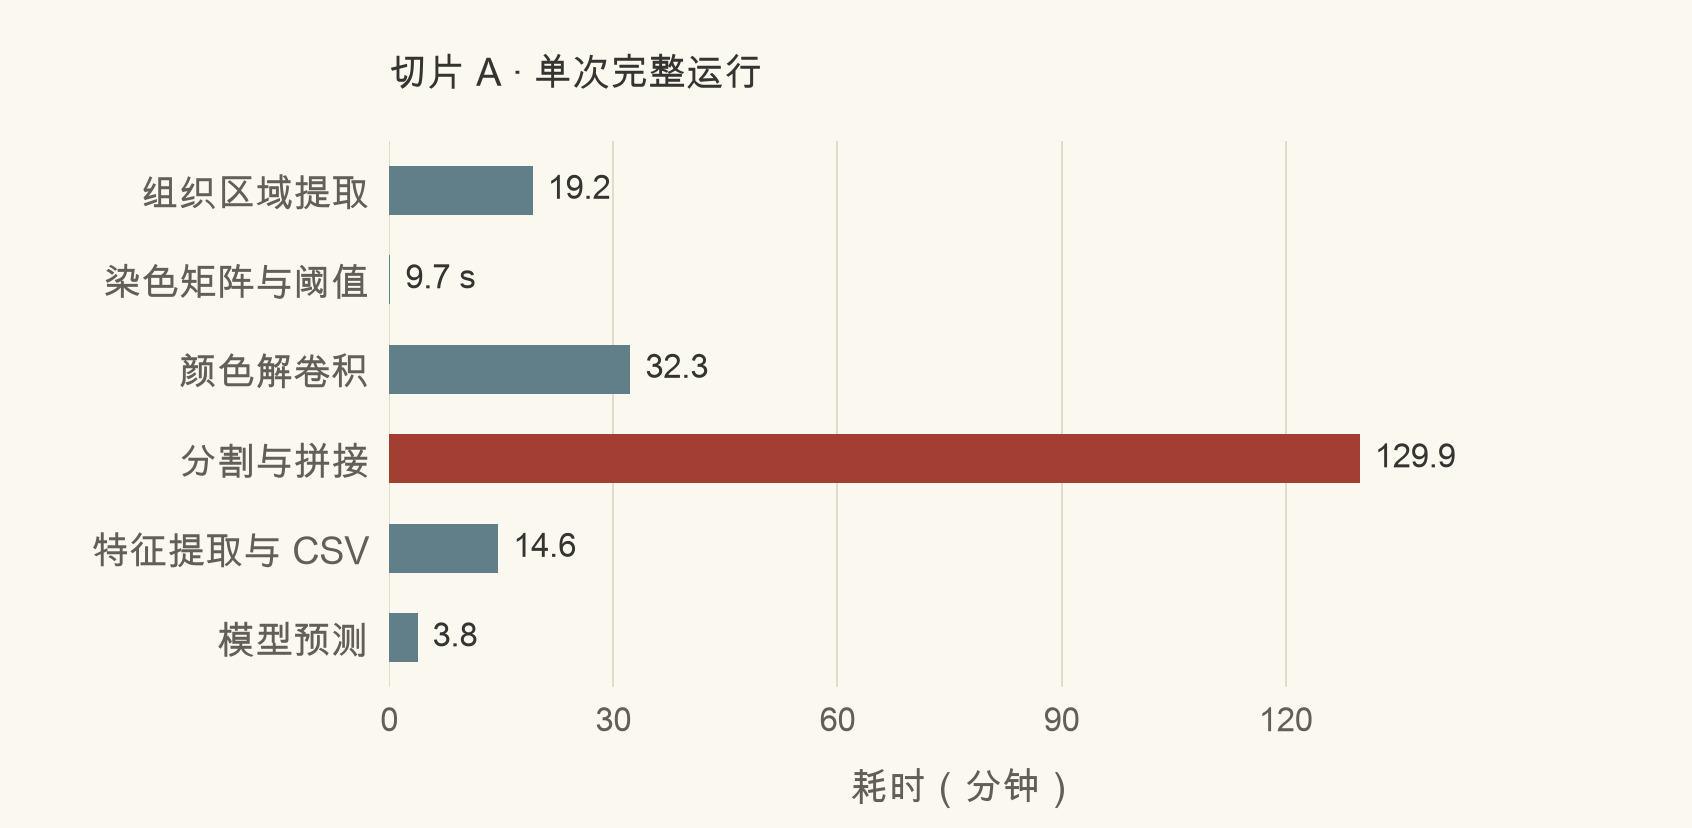 根据原报告数据重绘 · 表 5 · 第 34–35 页下载图表
查看图表数值
切片 A,原报告表 5 的单次完整运行记录。| 阶段 | 耗时(秒) |
|---|
| 组织区域提取 | 1,151.5 |
|---|
| 染色矩阵与阈值 | 9.7 |
|---|
| 颜色解卷积 | 1,936.9 |
|---|
| 分割与拼接 | 7,794.8 |
|---|
| 特征提取与 CSV | 875.4 |
|---|
| 模型预测 | 227.7 |
|---|
| 总耗时 | 11,996 |
|---|
耗时基于报告中的 Xeon Gold 6242 / Tesla V100 / 1 TiB RAM 工作站。报告摘要与正文的加速倍数表述不一致,本页采用可核对的表 5 数值。
这次实验还没回答的问题
验证范围只有两张切片,标注主要由我完成,尚未经过病理专家系统复核。结果说明了这组数据上的表现;跨患者、跨染色批次的稳定性,以及与临床结局的关系,还需要更多数据验证。
来源:本人 2025 年 5 月 NTU BS6211 实践项目报告,第 39–41 页。
Immunohistochemistry Biomarker Expression Pattern Recognition: For Enhanced Disease Prognosis